Tập tin vượt qua mọi bước kiểm tra
Bảo mật tập tin Các đường ống xử lý được xây dựng dựa trên một giả định hiếm khi bị đặt câu hỏi: mỗi tệp chỉ có một loại. Bộ phát hiện sẽ xác định loại tệp đó và chính sách sẽ định tuyến tệp theo loại đó. Sau đó, mọi mô-đun xử lý ở các giai đoạn tiếp theo sẽ phân tích tệp theo loại đó: chống phần mềm độc hại, môi trường cách ly và làm sạch dữ liệu.
Các tệp đa định dạng phá vỡ giả định này. Một luồng byte duy nhất có thể vừa là tệp GIF hoàn toàn hợp lệ , vừa là tệp lưu trữ Java hoàn toàn hợp lệ cùng một lúc. Thủ thuật này cũng áp dụng được với tệp JPEG đồng thời là tệp lưu trữ RAR, hoặc tệp PDF chứa một tệp ZIP hoàn chỉnh vượt quá điểm kết thúc logic của nó. Mỗi phần riêng lẻ đều tuân thủ tiêu chuẩn, do đó không có trình phân tích cú pháp định dạng nào phát hiện ra lỗi.
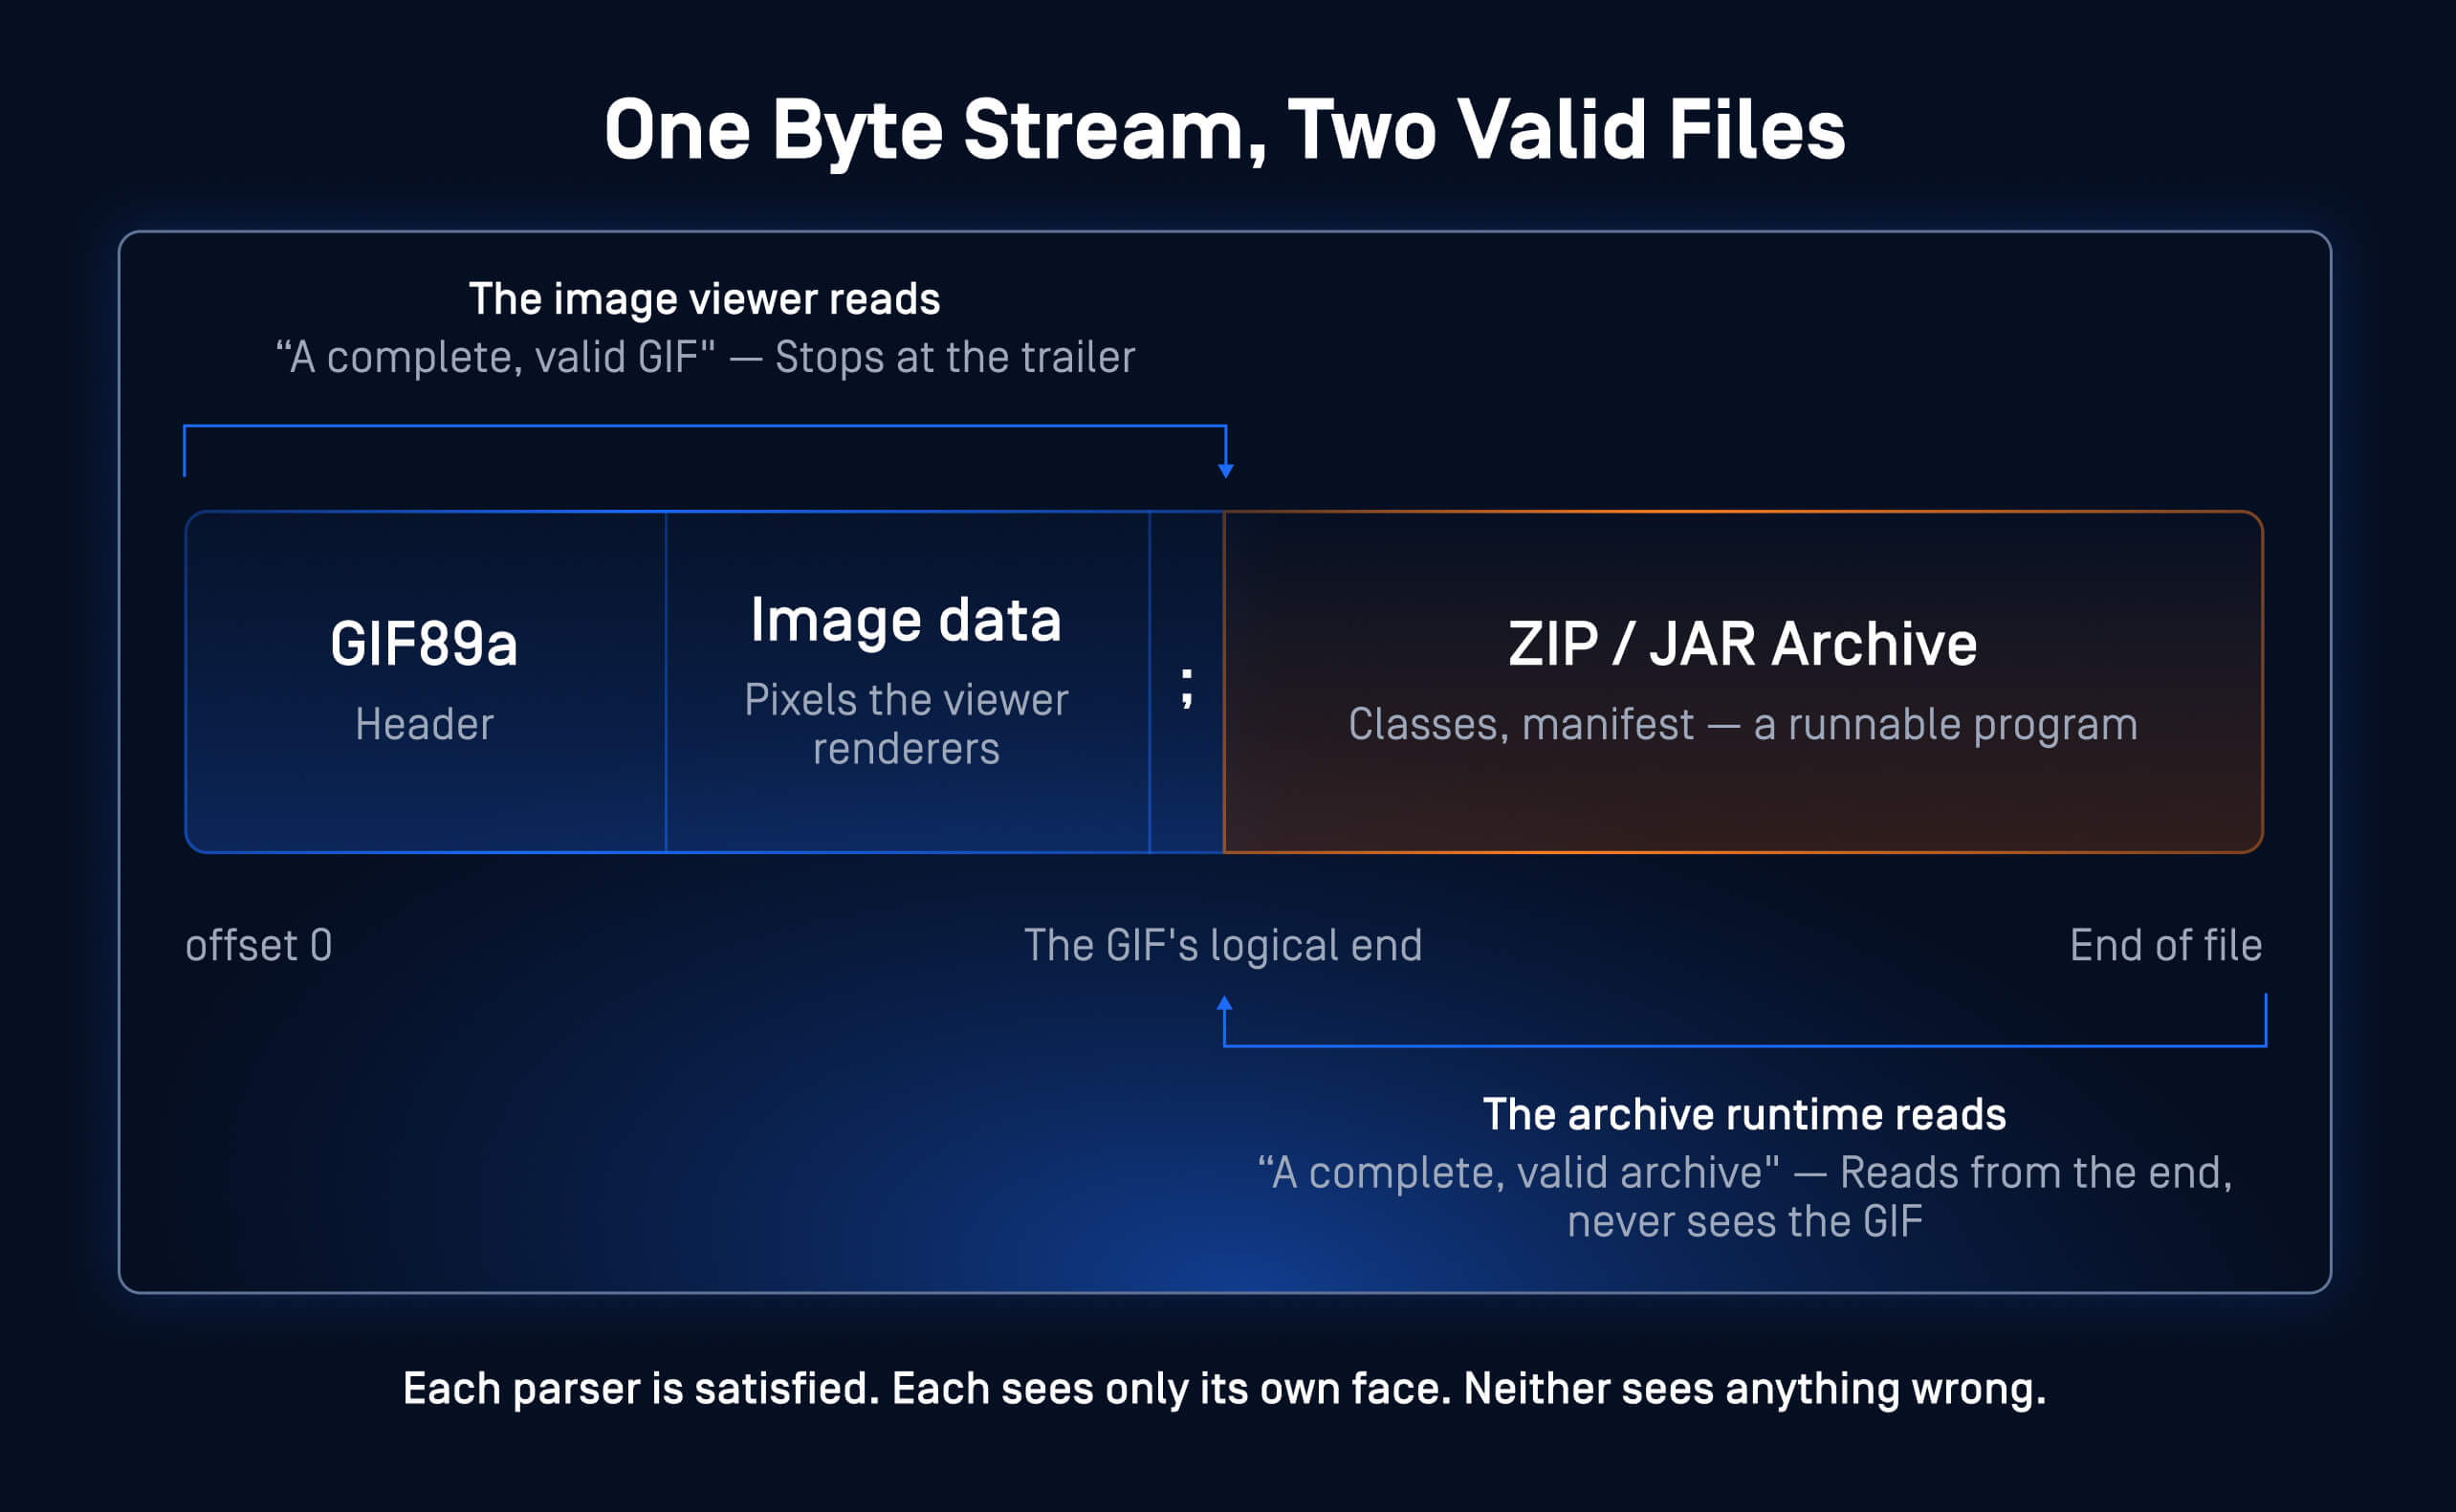
Một “người đa ngôn ngữ” trong một hình ảnh: định dạng GIF+JAR cổ điển. Hai trình phân tích cú pháp, hai điểm vào, một tệp, và mỗi “khuôn mặt” đều hoàn toàn hợp lệ.
Hậu quả về mặt bảo mật rất rõ ràng: hệ thống quét tệp theo loại mà nó phát hiện được, còn định dạng còn lại thì lọt qua mà không bị can thiệp. Một hình ảnh đồng thời là tập lệnh sẽ trở thành lỗ hổng XSS được lưu trữ khi ứng dụng web trả về tệp đó. Một tệp lưu trữ được ẩn đằng sau lớp vỏ hình ảnh sẽ đưa tải trọng của nó vượt qua các bộ lọc nội dung. Các chuỗi tấn công được xây dựng dựa trên ý tưởng này, từ sự kết hợp GIF+JAR kinh điển đến việc phân phối lỗ hổng với sự hỗ trợ của kỹ thuật ẩn thông tin, đã được công khai gần hai thập kỷ nay. Các công cụ chống phần mềm độc hại vẫn hầu như không phát hiện được chúng vì mỗi thành phần, khi được kiểm tra riêng lẻ, đều vô hại.
Cách động cơ tìm ra “một gương mặt thứ hai”
Công cụ Kiểm tra Cấu trúc Tệp của chúng tôi tích hợp tính năng phát hiện đa ngôn ngữ như một bước tiền xử lý được thực hiện trên mọi tệp được quét, trước khi bất kỳ bộ xử lý định dạng nào can thiệp. Thiết kế này dựa trên ba ý tưởng.
- Quét toàn bộ luồng dữ liệu. Trình quét sẽ so sánh toàn bộ tệp với danh sách các chữ ký định dạng đặc trưng. Nếu phát hiện một định dạng khác xuất hiện ở bất kỳ vị trí nào trong luồng dữ liệu, hệ thống sẽ hiển thị vị trí chính xác của nó, ngay cả khi tệp đã được xác định loại định dạng. Điều này bao gồm cả các chữ ký được thêm vào sau dấu hiệu kết thúc tệp PDF hoặc ẩn sau dữ liệu pixel của hình ảnh.
- Xác định chính xác điểm kết thúc hợp lệ của một định dạng. Các định dạng như Container được phép chứa các tệp khác bên trong. Một hình ảnh bên trong tệp ZIP được coi là nội dung thông thường. Công cụ phát hiện xác định điểm kết thúc thực sự của từng vùng chứa dựa trên cấu trúc riêng của chính vùng chứa đó. Phần cuối (trailer) của tệp PDF, thư mục trung tâm của tệp ZIP và phân vùng bộ nhớ của tệp hợp nhất OLE (Object Linking and Embedding) đều đánh dấu ranh giới này. Quá trình phân tích PDF tính đến các bản cập nhật tăng dần. Chỉ các chữ ký nằm ngoài cấu trúc đó mới được coi là một “mặt” thứ hai. Ranh giới cấu trúc này chính là yếu tố phân biệt giữa kết quả phát hiện đa định dạng chính xác và cảnh báo sai đối với mọi tệp lưu trữ thông thường.
- Hãy xác nhận kỹ trước khi kết luận. Hệ thống sẽ tách từng “ứng viên” ra khỏi luồng dữ liệu và xác định lại chúng một cách độc lập bằng công cụ File Type của chúng tôi trước khi báo cáo. Các “ứng viên” được xác định là dữ liệu không có cấu trúc sẽ bị loại bỏ. Một kết luận chính xác có nghĩa là một định dạng thứ hai thực sự được phân tích cú pháp tại vị trí đó. Chỉ riêng các byte ngẫu nhiên không bao giờ tạo ra kết quả như vậy.
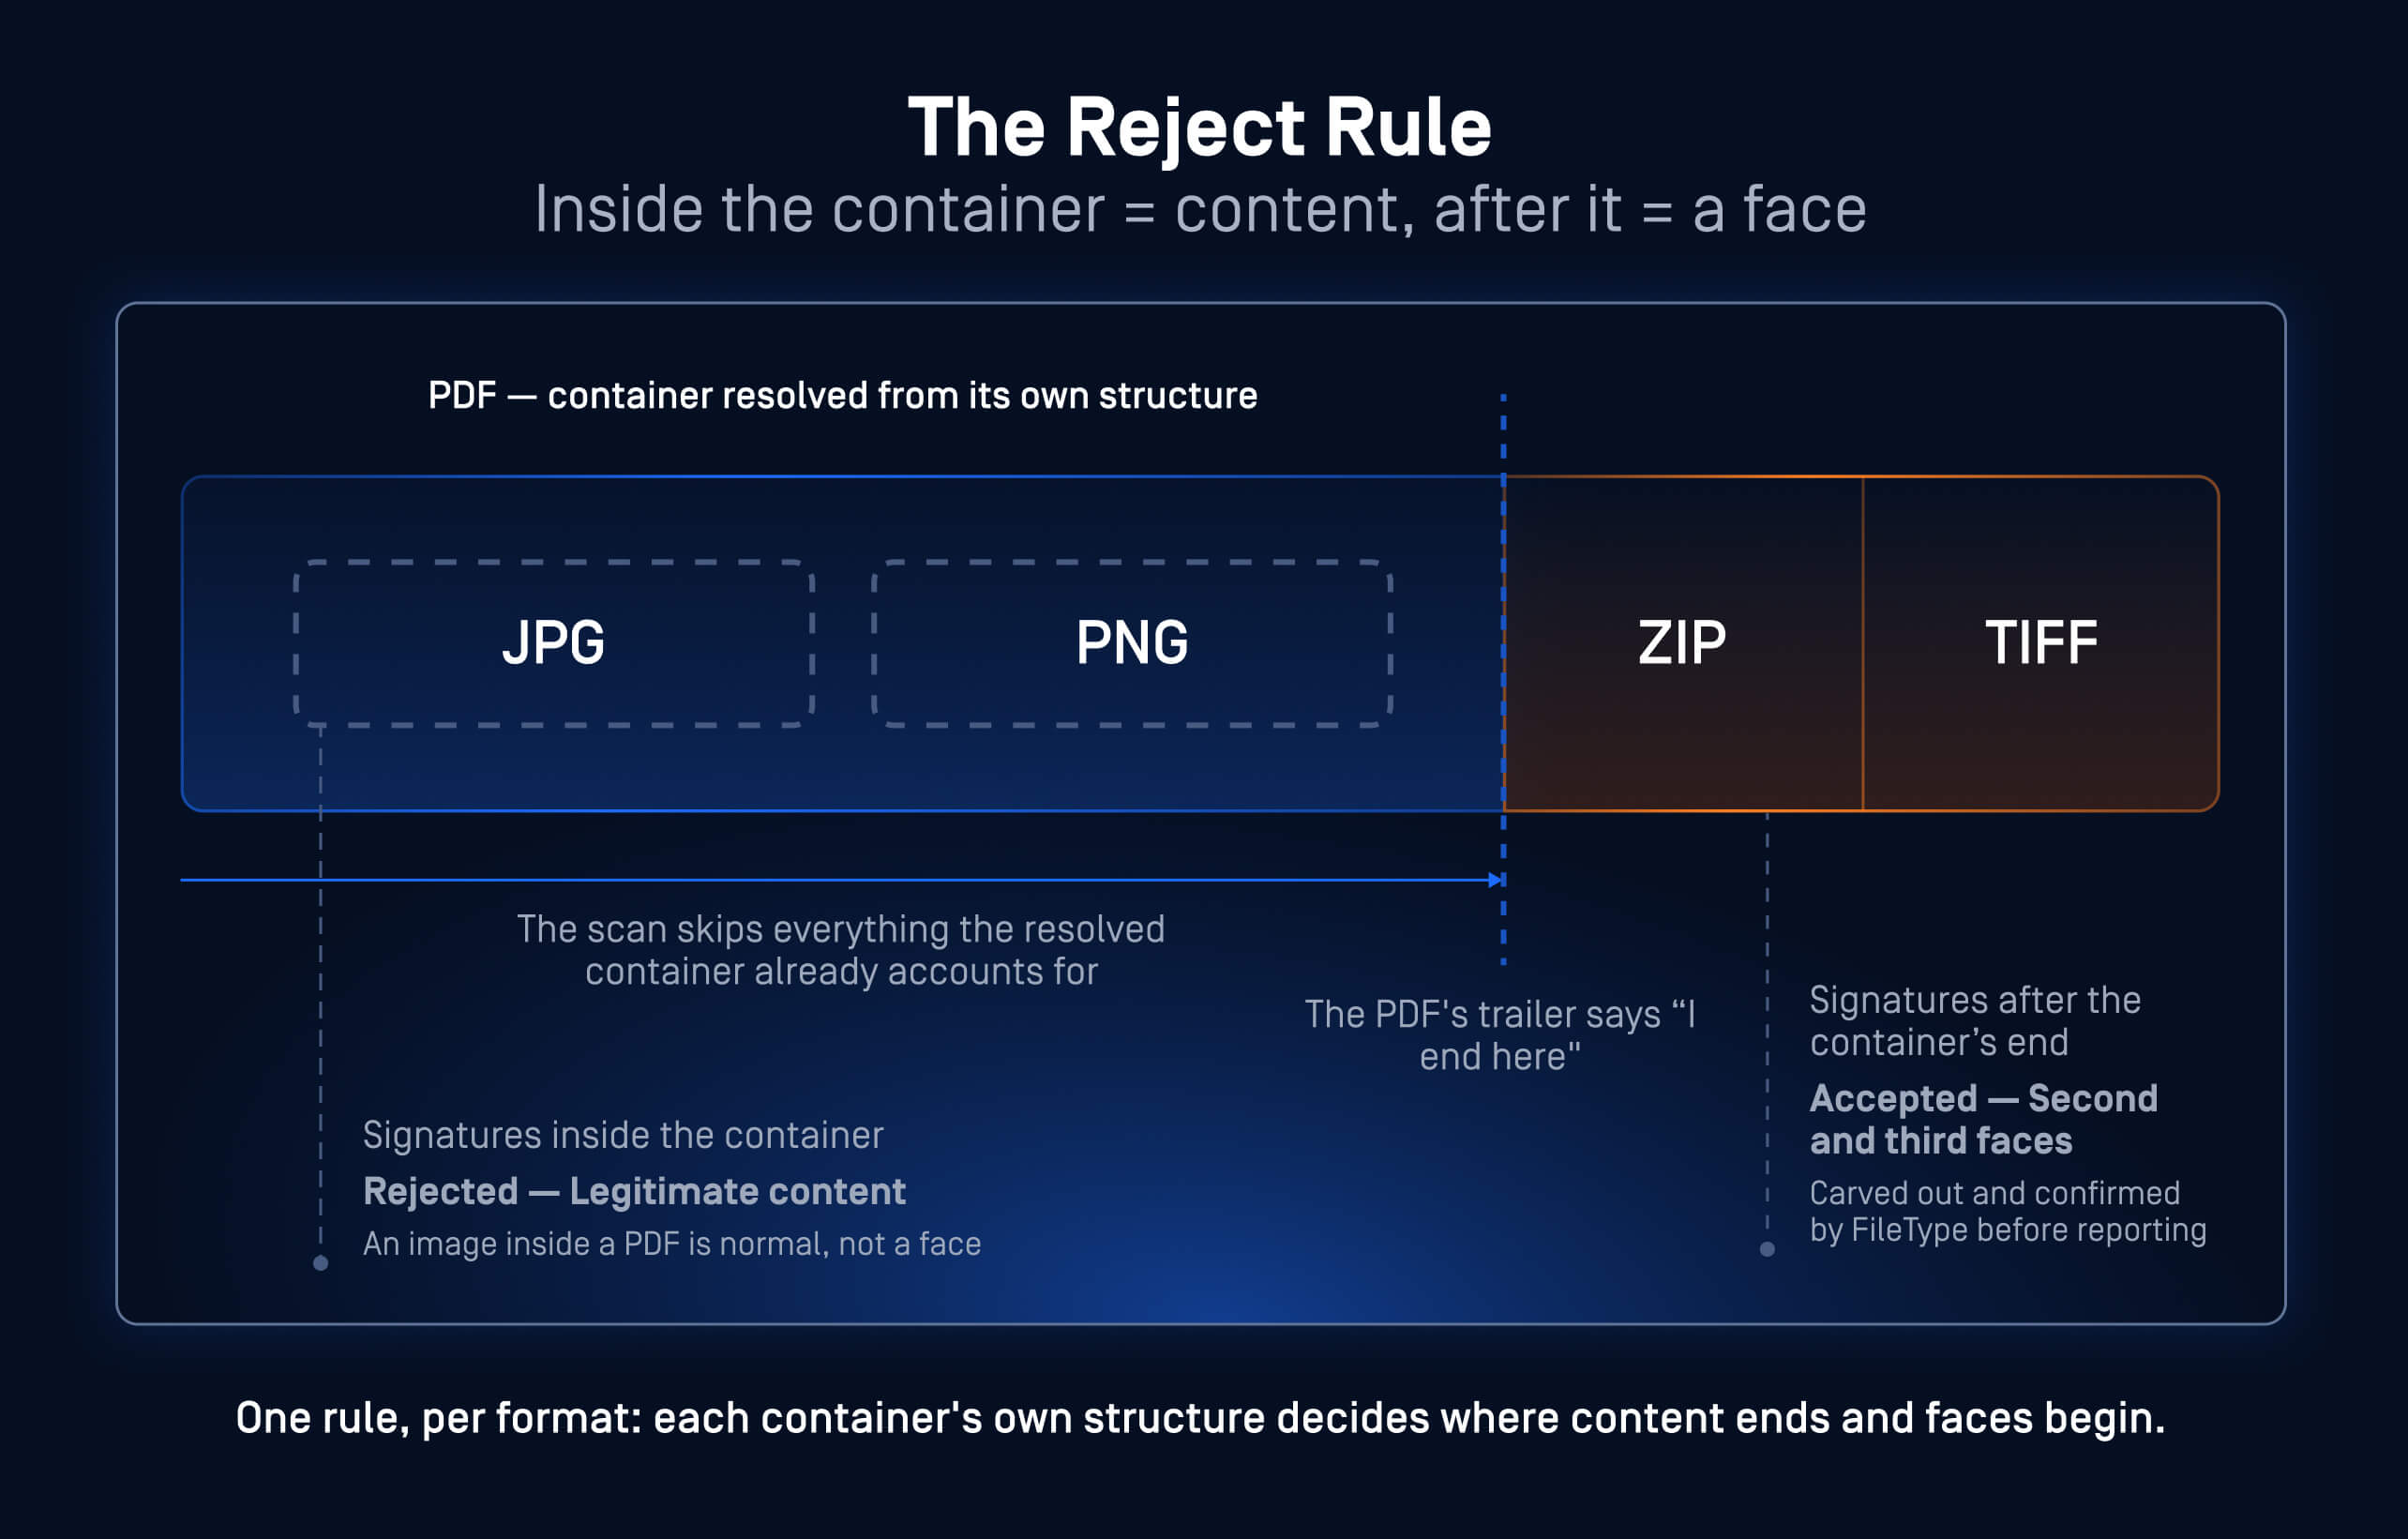
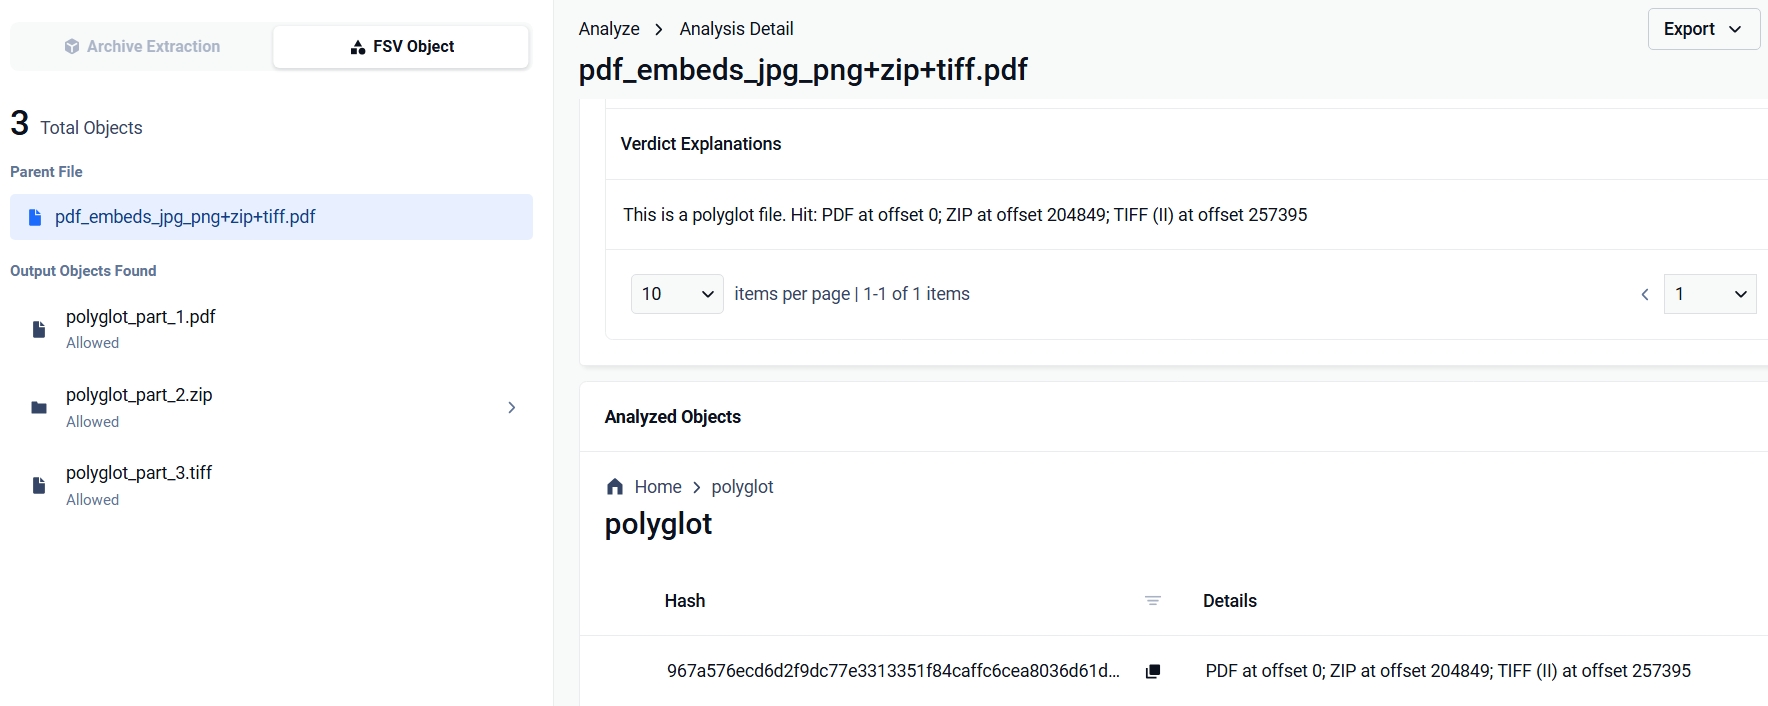
Lấy từ một mẫu thực tế: một tệp PDF chứa nhúng một tệp JPG và một tệp PNG, với một tệp ZIP và một tệp TIFF được thêm vào phía sau điểm kết thúc logic của tệp. Kết quả kiểm tra nêu rõ tên của tệp ZIP và tệp TIFF nhưng không đề cập đến các hình ảnh được nhúng.
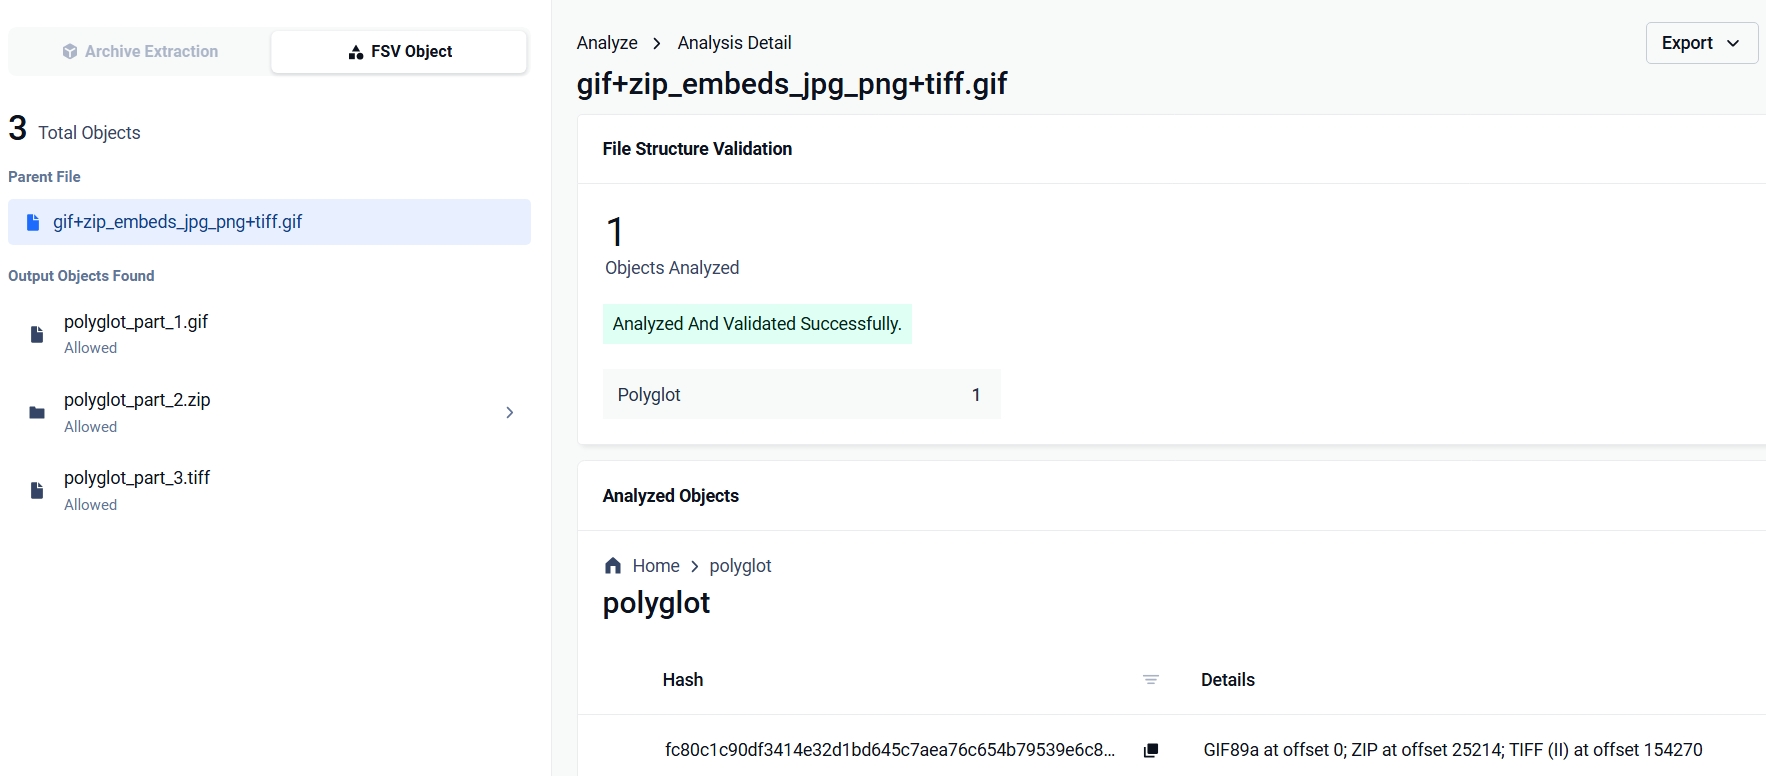
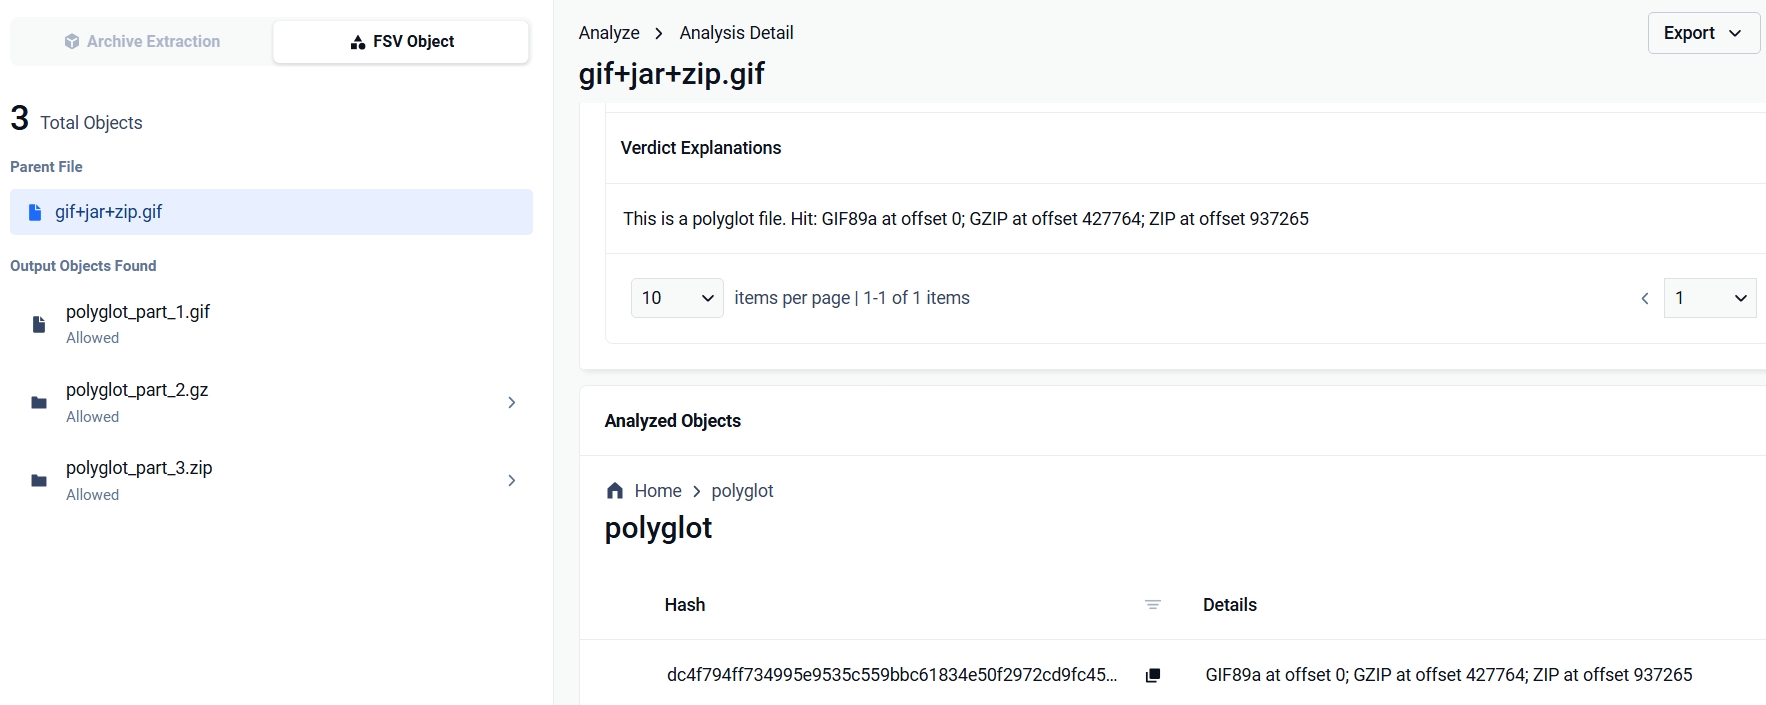
Kết quả báo cáo từng mặt dữ liệu cùng với vị trí của nó. Ví dụ, một tệp .gif được tải lên sẽ được xác định là GIF89a tại vị trí 0 và là một tệp nén ZIP ở phần sâu hơn trong luồng dữ liệu. Chính sách sẽ quyết định các bước tiếp theo: báo cáo phát hiện này hoặc chặn hoàn toàn tệp đó kèm theo lời giải thích liệt kê các kết quả trùng khớp.
Từ việc phát hiện đến việc mổ xẻ
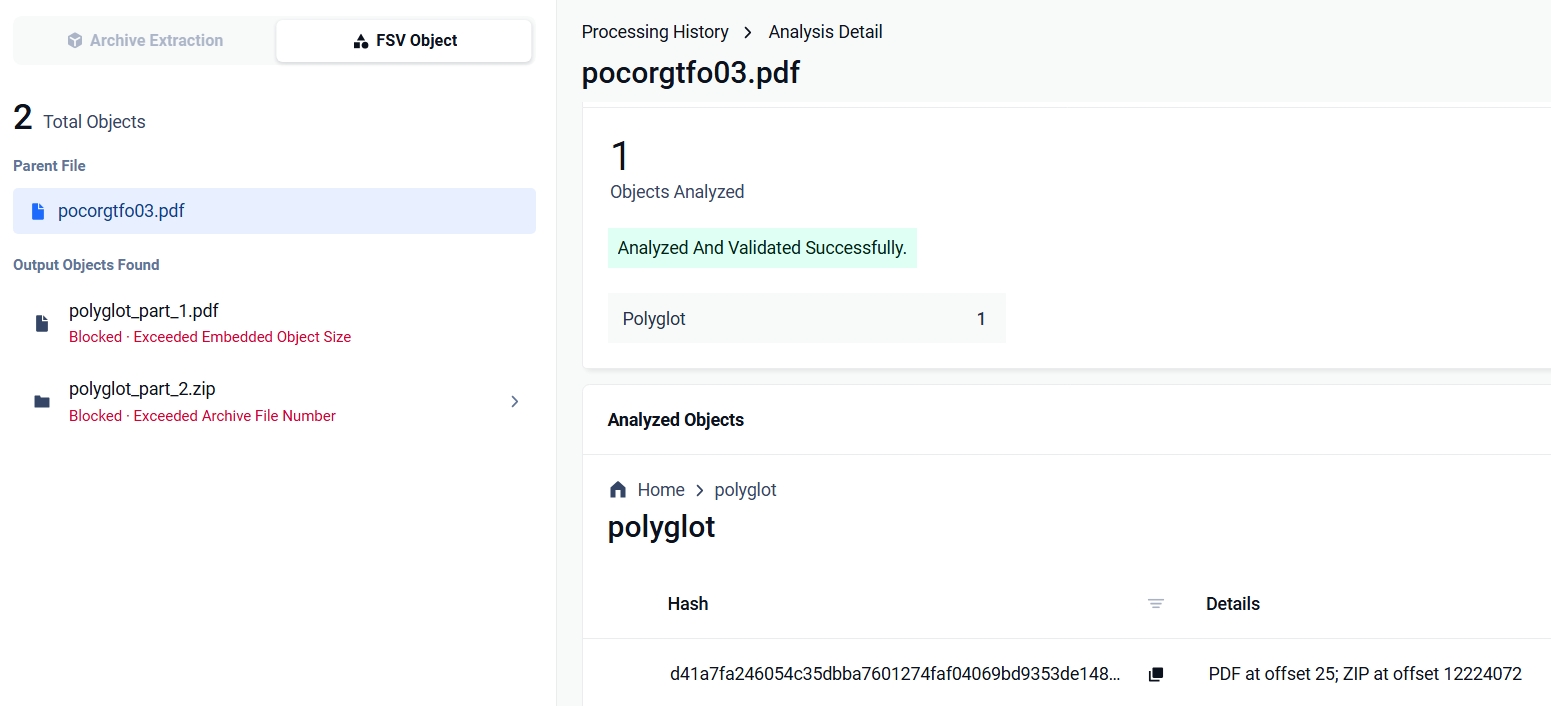
Việc phát hiện chỉ là một nửa giải pháp, bởi vì mánh khóe của “polyglot” nằm ở chỗ mỗi “khuôn mặt” riêng lẻ đều trông vô hại. Sau khi phát hiện, bộ xử lý sẽ phân tích chi tiết tệp. Mỗi “khuôn mặt” được xác nhận sẽ được xuất ra dưới dạng một đối tượng riêng biệt (polyglot_part_1.pdf, polyglot_part_2.zip, v.v.) kèm theo định dạng, vị trí và kích thước của nó. Bộ xử lý sau đó chuyển từng đối tượng này trở lại quy trình làm việc củaMetaDefender Core™ để xử lý toàn diện theo đúng bản chất thực sự của nó.
Chúng tôi đã kiểm tra toàn bộ quy trình này trên một phiên bản MetaDefender Core™ đang hoạt động.
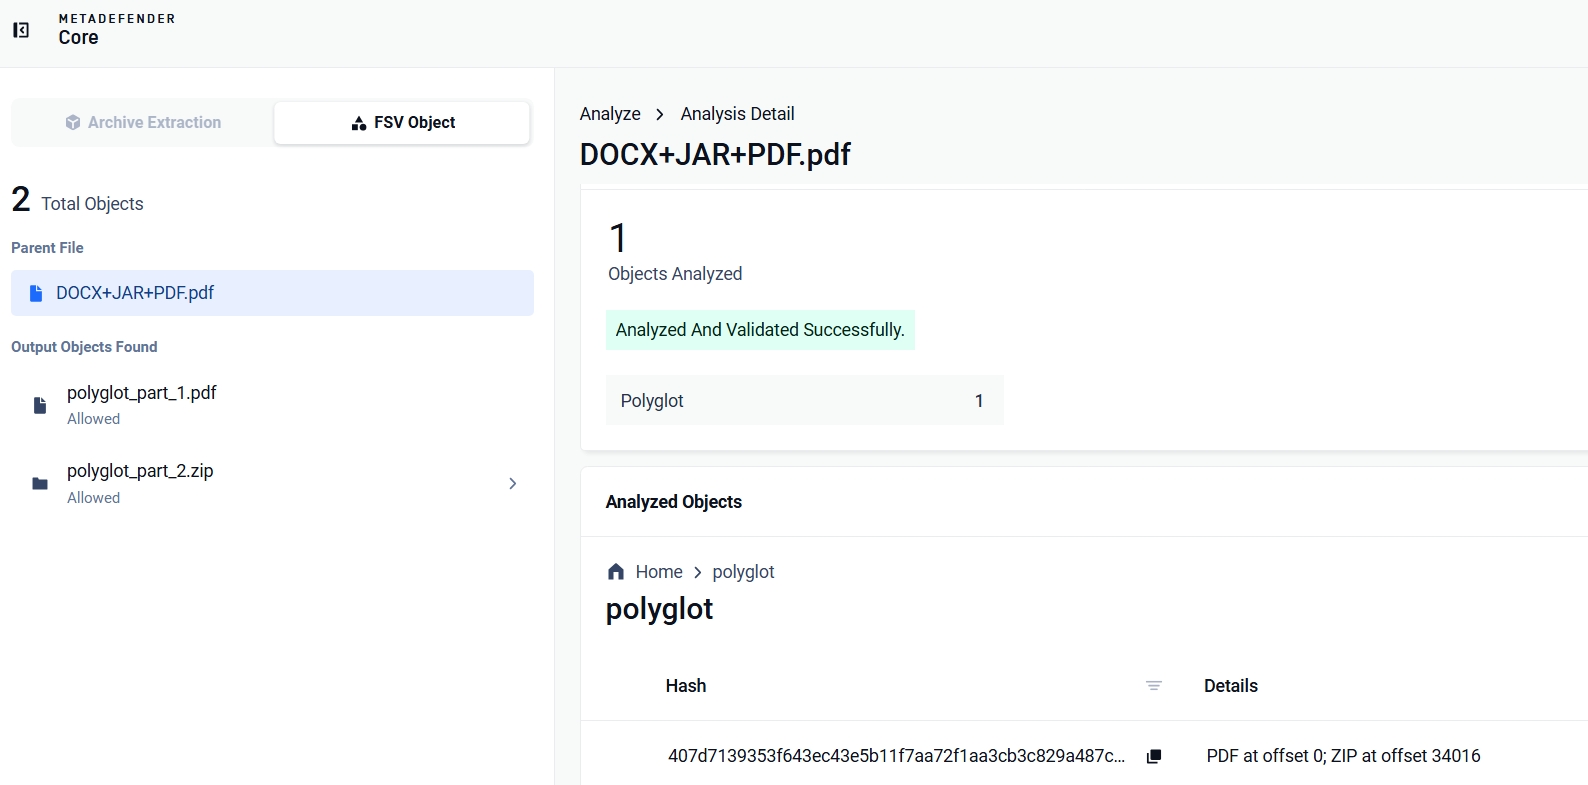
Công cụ này đã tách một tệp PDF mẫu chứa ẩn một tài liệu Word (một tệp đa định dạng PDF+JAR+DOCX) thành hai phần: phần PDF và phần ZIP. Vì cả JAR và DOCX đều là các thùng chứa ZIP, nên một phần ZIP có thể đáp ứng cả hai tiêu chuẩn. Sau đó, công cụ File Type đã xác định phần đó là DOCX, và Công nghệ Deep CDR™ làm sạch đã xử lý nó một cách riêng biệt. Phần ẩn này nhận được chính xác cách xử lý mà nó được thiết kế để né tránh.
Độ chính xác mới là phần khó nhất
Các “byte ma thuật” xuất hiện một cách tự nhiên trong các tệp vô hại, vì vậy nỗ lực kỹ thuật thực sự nằm ở việc không “cảnh báo hụt”. Ảnh chụp từ máy ảnh nhúng các hình thu nhỏ EXIF mang chữ ký JPEG riêng. Các tài liệu Office nhúng hình ảnh bên trong cấu trúc chứa của chúng. Các tệp định dạng “ Media ” chứa ngẫu nhiên các chuỗi byte trông giống như tiêu đề nén. Logic phát hiện loại trừ các byte đã được cấu trúc hợp lệ giải thích, và việc tăng cường bảo mật này liên tục được mở rộng theo từng định dạng. Một trình phát hiện đánh dấu mọi ảnh chụp từ máy ảnh sẽ bị tắt đi, và một trình phát hiện bị tắt sẽ không bảo vệ được ai cả.
Đã được kiểm chứng với những người thực sự thông thạo nhiều ngôn ngữ
Chúng tôi đã chạy các mẫu đa ngôn ngữ thực tế qua một môi trường triển khai MetaDefender Core™ đang hoạt động, sử dụng công cụ Kiểm tra cấu trúc tệp. Tất cả các lỗi đều được phát hiện, và vị trí của mỗi lỗi đều được xác định chính xác đến từng byte:
Ví dụ | Các mặt đã tìm thấy (chênh lệch) | Kết quả |
Tệp PDF chứa tài liệu Word (gồm PDF, JAR và DOCX trong cùng một tệp) | PDF @ 0 · ZIP @ 34.016 | Đã trích xuất khuôn mặt; tệp DOCX ẩn làm sạch nhờ công nghệ Deep CDR™ |
GIF ẩn một tệp nén và một hình ảnh khác | GIF89a @ 0 · ZIP @ 25.214 · TIFF @ 154.270 | Đã phát hiện |
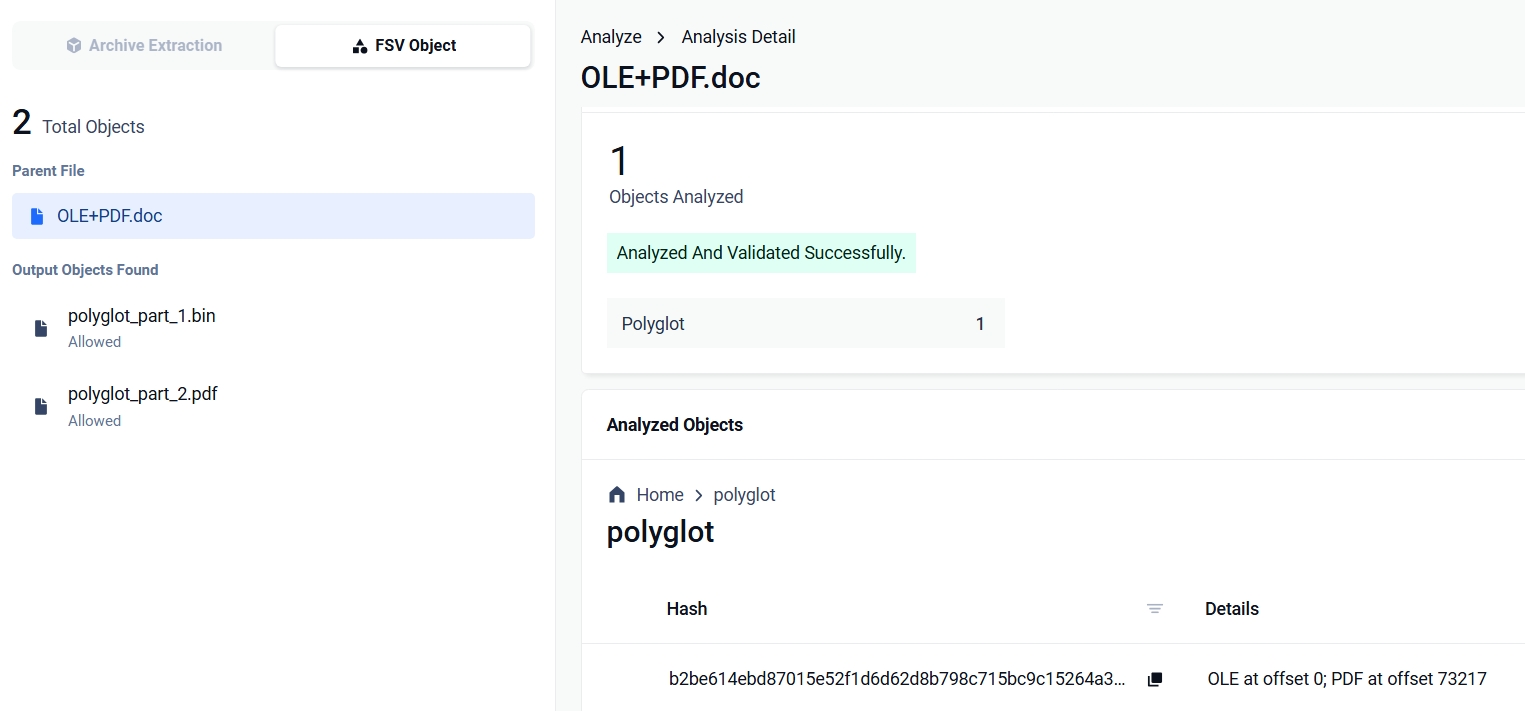
Tài liệu văn phòng chứa tệp PDF ẩn bên trong | OLE @ 0 · PDF @ 73.217 | Đã phát hiện |
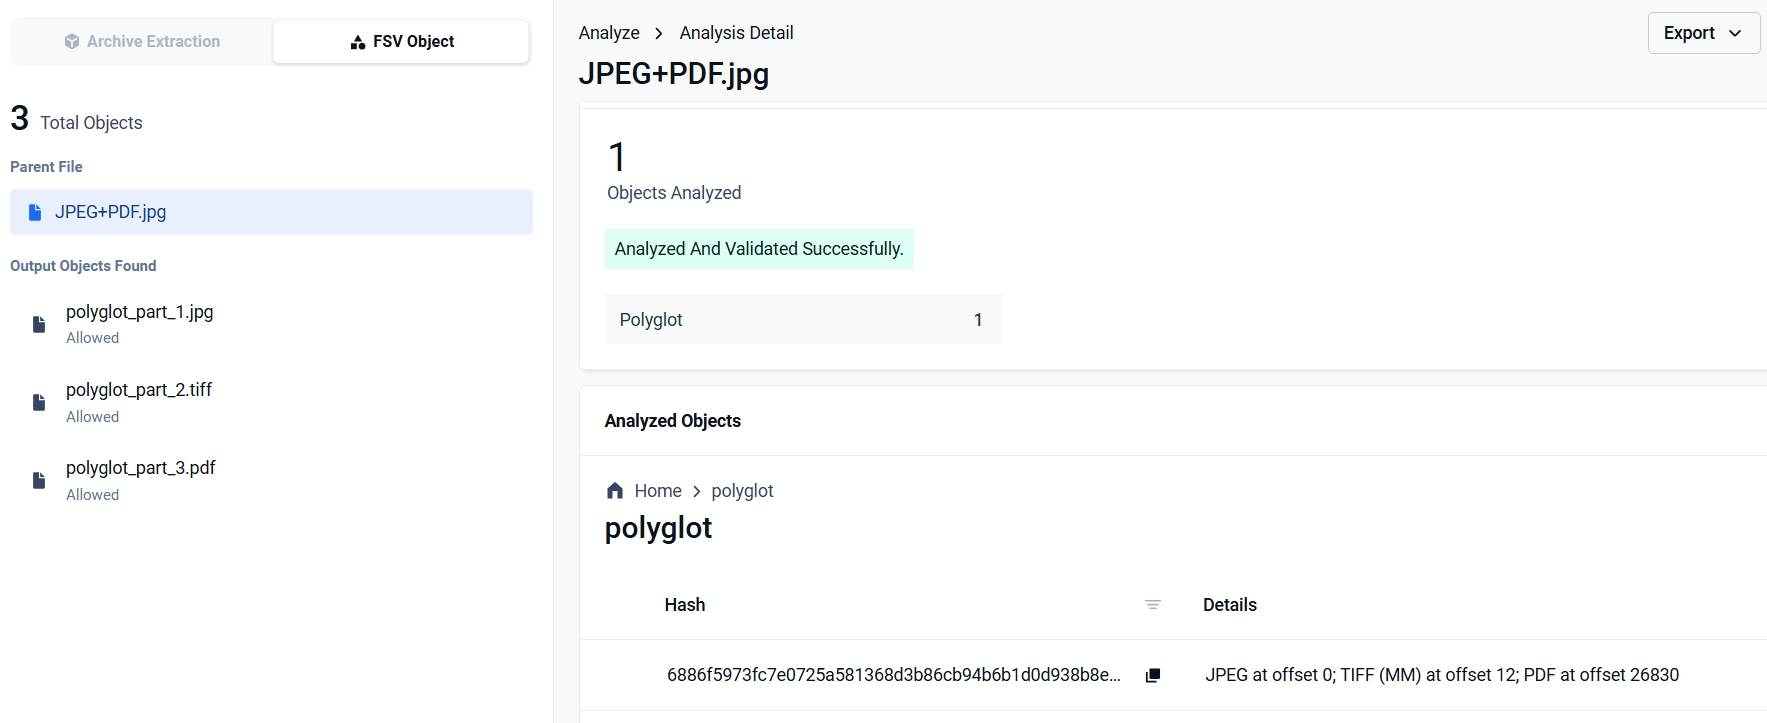
Ẩn tệp PDF trong tệp JPEG | Ba khuôn mặt, tệp PDF đính kèm @ 26.830 | Đã phát hiện |
PoC‖GTFO số 3, tạp chí nghiên cứu bảo mật được biên soạn dưới dạng tệp PDF+ZIP đa ngôn ngữ, dung lượng 26 MB | PDF @ 25 · ZIP @ 12.224.072 | Đã phát hiện: đã tìm thấy tệp “the second face” ở độ sâu 12 MB trong quá trình quét toàn bộ |
Tệp GIF chứa luồng GZIP và tệp lưu trữ Java | GIF89a @ 0 · GZIP @ 427.764 · ZIP @ 937.265 | Bị chặn |
Tệp PDF chứa một tệp JPG và một tệp PNG, kèm theo một tệp ZIP và một tệp TIFF | PDF @ 0 · ZIP @ 204.849 · TIFF @ 257.395 | Bị chặn; các hình ảnh được nhúng không được báo cáo đúng cách |
Dòng cuối cùng minh họa quy tắc loại trừ đang hoạt động: kết quả chỉ định các tệp ZIP và TIFF được đính kèm và bỏ qua các hình ảnh bên trong tệp PDF. Bộ giải quyết container đã coi chúng là nội dung của chính tệp PDF. Dữ liệu JSON kết quả từ MetaDefender Core™ cho tệp đó (đã rút gọn):
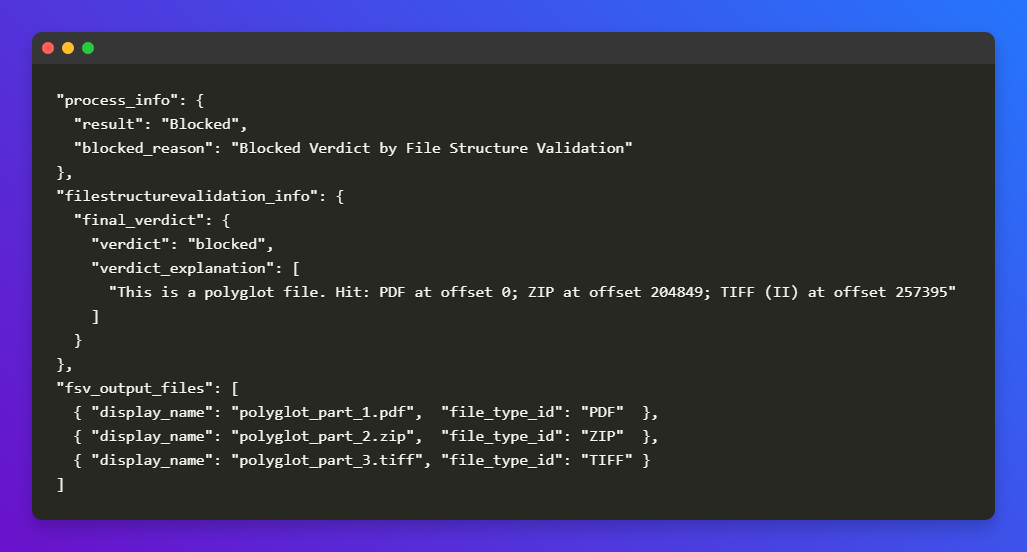
Danh sách fsv_output_files chính là quá trình phân tách đã được mô tả ở trên, dưới dạng dữ liệu trực tiếp: ba mặt được tách ra và trả về cho quy trình làm việc dưới dạng các đối tượng riêng biệt.
Dưới đây là các ảnh chụp màn hình của từng kết quả mẫu trong MetaDefender Core™:
Phạm vi áp dụng và cấu hình
Phạm vi bảo vệ hiện nay bao gồm các định dạng mà những kẻ tấn công thực tế kết hợp với nhau: PDF, ZIP, tệp hỗn hợp OLE, PNG, GIF, JPEG, TIFF, RAR, GZIP và 7z.
Cơ chế xử lý kết thúc vùng chứa theo cấu trúc áp dụng cho các định dạng vùng chứa. Tính năng này được triển khai theo nguyên tắc “cấu hình trước”: các chức năng phát hiện, chặn và quét toàn bộ tệp đều là các tùy chọn chính sách riêng biệt, do đó người vận hành có thể lựa chọn giữa việc theo dõi và thực thi tùy theo từng lần triển khai.
Nói tóm lại
Một tệp có hai mặt hợp lệ sẽ làm thất bại bất kỳ quy trình xử lý nào gán cho nó một loại duy nhất, trong khi việc phát hiện loại đơn là nền tảng mà hầu hết các hệ thống quét đều được xây dựng dựa trên. Công nghệ phát hiện đa loại cấu trúc lấp đầy lỗ hổng đó bằng cách xác định mọi mặt và chứng minh rằng mỗi mặt đều có thể được phân tích cú pháp. Sau đó, hệ thống chính sách có thể chặn tệp đó trước khi bất kỳ ứng dụng nào chọn trình thông dịch sai.
Hiện tại, hệ thống đã hỗ trợ phát hiện các định dạng tấn công phổ biến. Việc giải quyết vấn đề “end-of-container” đối với các định dạng tệp lưu trữ còn lại sẽ được triển khai theo lộ trình phát triển.
Hãy xem cách tính năng Xác thực cấu trúc tệp xử lý các định dạng tệp được truyền qua môi trường của bạn.